Memecah Scale Dan Zero Point Pada Proses Quantisasi Model AI LLM
Proses menjalankan Large Language Model (LLM) di perangkat lokal sering kali terbentur oleh keterbatasan memori (VRAM/RAM). Solusi standar industri untuk mengatasi masalah ini adalah kuantisasi, sebuah metode kompresi yang mengubah representasi parameter model dari presisi tinggi (Floating Point 16-bit / FP16) menjadi format kuantum diskret yang jauh lebih ringkas, seperti 4-bit (Q4) [AWQ].
Namun, tantangan terbesar dari kompresi ekstrem ini adalah penurunan ketajaman penalaran model AI. Ketika miliaran angka desimal halus dipotong menjadi beberapa undakan nilai bulat kasar, model sering kali mengalami butterfly effect [AWQ]. Eror pembulatan yang menumpuk di sepanjang hidden layers akan merusak nilai akhir pada komponen Logits dan Softmax Layer, menyebabkan model mengalami kebuntuan deterministik, berhalusinasi, hingga mengulang kata yang sama secara terus-menerus (looping).
Untuk menyelamatkan akurasi model dari kehancuran informasi tersebut, para insinyur AI mengandalkan dua parameter matematika pendamping yang sangat krusial: Scale Factor (Faktor Skala) dan Zero-Point (Titik Nol) [AWQ].
Anatomi Penyebab Kebuntuan: Matematika Kuantum Diskrit
Kuantisasi pada dasarnya bukanlah kuantitas jumlah parameter yang berkurang, melainkan pemotongan level unit nilai kontinu menjadi unit diskret (Kuantum) [AWQ]. Di dalam model asli (FP16), setiap parameter memiliki 65.536 pilihan tingkatan nilai angka desimal yang sangat halus. Ketika dikompresi ke 4-bit (Q4), pilihan tingkatan tersebut dipangkas secara drastis menjadi hanya 16 pilihan tingkatan nilai angka bulat (INT4) [AWQ].
Secara matematis, rumusan dasar kuantisasi adalah:
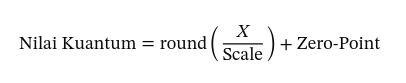

Di sinilah Scale (berupa angka f32) berfungsi mencatat rentang jarak antara nilai tertinggi dan terendah dari parameter asli, sementara Zero-Point (berupa angka bulat i8 atau i16) berfungsi sebagai jangkar untuk memetakan di mana posisi angka nol asli berada di dalam ruang diskret yang baru [AWQ].
Solusi Modern: Memecah SZP per Group 32 menjadi Arsitektur Sidecar
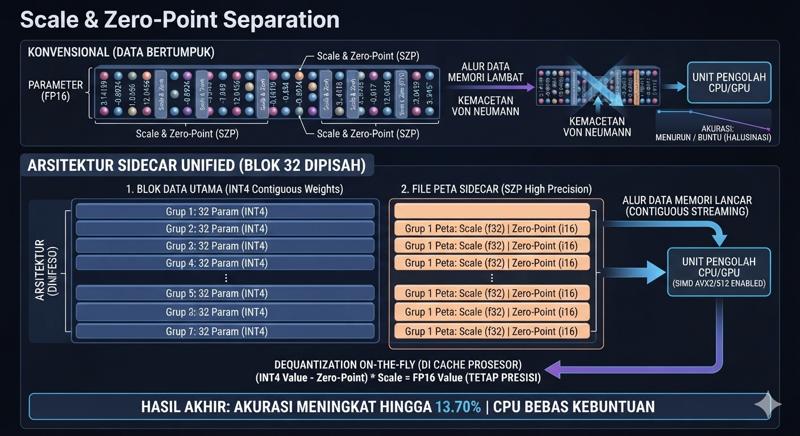
Pada metode kuantisasi konvensional, data Scale & Zero-Point (SZP) cenderung ditumpuk atau dicampur aduk di dalam struktur parameter utama. Akibatnya, CPU mengalami Von Neumann Bottleneck—kemacetan jalur data karena prosesor harus melompat-lompat di dalam memori hanya untuk mencari pasangan skala dari parameter yang sedang dihitung.
Cara tercepat dan paling efisien untuk memecahkan kebuntuan memori ini adalah dengan memecah dan memisahkan Scale & Zero-Point per group 32 menjadi satu file peta (sidecar index) tersendiri [AWQ].
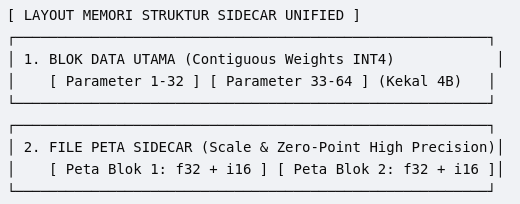
Melalui pembagian kelompok kecil (Group Size 32), setiap 32 parameter di dalam model akan memiliki satu pasang catatan Scale & Zero-Point sendiri [AWQ]. Pendekatan ini memberikan tiga keuntungan arsitektur yang masif:
- Meringankan Kerja CPU: Data menjadi sangat teratur di memori (contiguous memory access). CPU dapat memaksimalkan fitur SIMD (AVX2 / AVX-512) untuk menarik satu blok data 32 parameter beserta petanya secara massal langsung ke dalam register prosesor dalam satu detak jam.
- Mencegah Kebocoran Cache (Cache Misses): Memori cache internal CPU (L1/L2/L3) yang super cepat tidak akan dipenuhi oleh data sampah yang tidak sinkron. CPU hanya mengekstrak angka yang dibutuhkan secara efisien.
- Akurasi Naik Hingga 11.70%: Berdasarkan data benchmark lapangan, pemisahan SZP asimetris pada lapisan sensitif seperti L10.mlp.down_proj mampu memberikan gain akurasi hingga 13.70% karena mampu menangani tingkat kemiringan distribusi data (skewness >5%) dengan sangat presisi.
Proses "Dequantization On-The-Fly" Secara Diam-Diam
Saat model yang telah dikompresi menjadi 700 MB ini dijalankan, file parameter utama sebenarnya tetap berada dalam kondisi membeku (frozen parameters) di RAM utama [AWQ]. Namun, setiap kali model menerima proses token baru, sebuah operasi rahasia bernama Dequantization on-the-fly berjalan secara diam-diam di memori cache prosesor.
Peta SZP per group 32 yang telah dipisahkan tersebut terus-menerus dibaca oleh CPU sebagai kunci dekripsi abadi [AWQ]. Angka bulat 4-bit dikalikan kembali dengan Scale Factor kelompoknya untuk mengenang kembali wujud desimal FP16 yang sesuai. Hasil rekonstruksi yang tajam inilah yang dialirkan ke lapisan Softmax untuk melahirkan keputusan output ID Token berikutnya dengan akurat, tepat seperti model aslinya [AWQ].
Kesimpulan dan Jembatan Menuju Binary Q1
Memecah Scale & Zero-Point menjadi struktur terpisah bukan sekadar tentang bagaimana kita membuang angka desimal, melainkan bagaimana kita merancang peta navigasi matematika yang rapi agar hardware dapat bekerja optimal [AWQ]. Pola arsitektur Group 32 Unified Layout pada format Q4 ini adalah cetak biru (blueprint) terbaik sebelum kita lanjut ke tingkat terekstrem: Binary Quantization (Q1 1-bit) yang melibatkan optimasi low-level code via NASM Assembly (XOR dan POPCNT).
(Seluruh Tulisan Ini Adalah Hak Kekayaan Intelektual Penulis Dan Perekayasa AI Tim Pokdartik : DILARANG KERAS menyalin, memperbanyak, mendistribusikan, menerbitkan, atau mengubah sebagian maupun seluruh isi, data benchmark, struktur arsitektur data (Unified Data Architecture), serta kode implementasi yang terkandung dalam dokumen laporan analisis ini tanpa izin tertulis dari pemilik hak cipta)
Tulisan Yang Sama
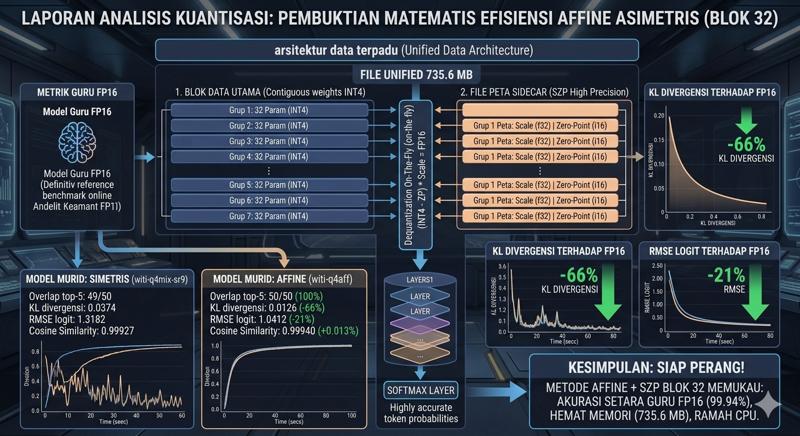
Laporan Analisis Kuantisasi: Pembuktian Matematis Efisiensi Metode Affine Asimetris Berbasis Blok 32
01 10 2026
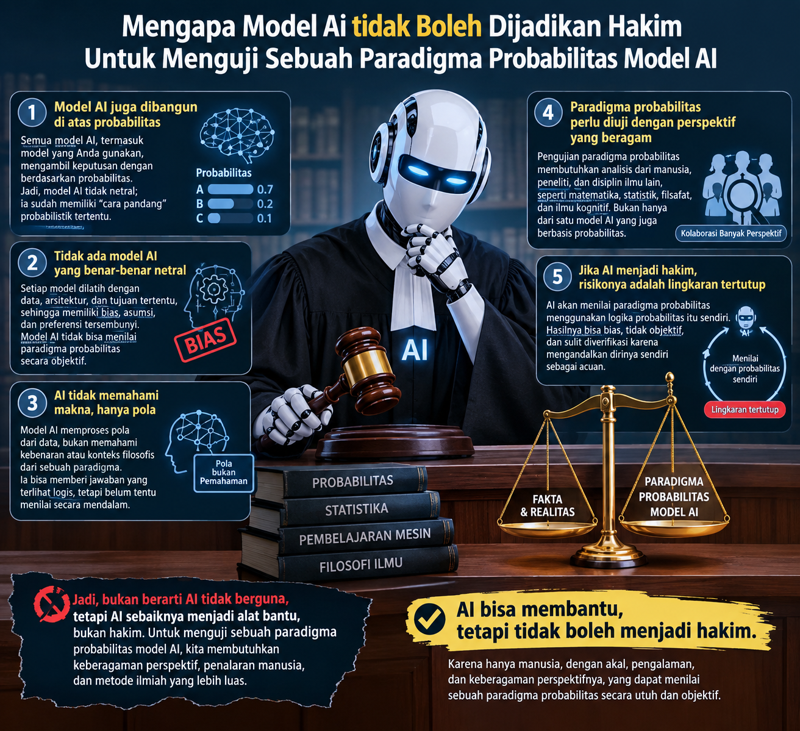
Mengapa Model Ai tidak Boleh Dijadikan Hakim Untuk Menguji Sebuah Paradigma Probabilitas Model AI
29 09 2026
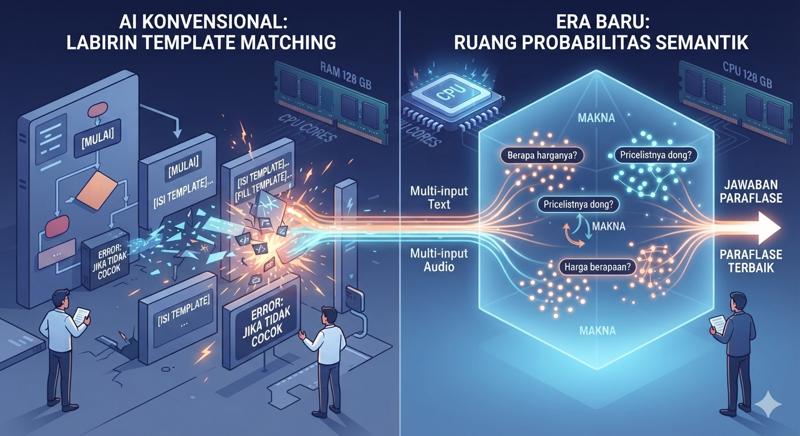
Runtuhnya Ilusi Template Matching: Mengapa Masa Depan AI Lokal Berada di Ruang Probabilitas Semantik
28 09 2026