Mengapa Model Ai tidak Boleh Dijadikan Hakim Untuk Menguji Sebuah Paradigma Probabilitas Model AI
Perkembangan pesat kecerdasan buatan (AI) telah membawa Large Language Model (LLM) ke dalam berbagai peran baru, termasuk sebagai alat bantu evaluasi penelitian. Namun, ketika model AI digunakan sebagai hakim tunggal untuk menguji atau mengevaluasi sebuah paradigma baru dalam arsitektur probabilitas AI itu sendiri, muncul tantangan metodologis yang mendasar. Pemisahan peran antara objek yang diteliti dan alat yang menilai menjadi krusial demi menjaga objektivitas ilmiah.
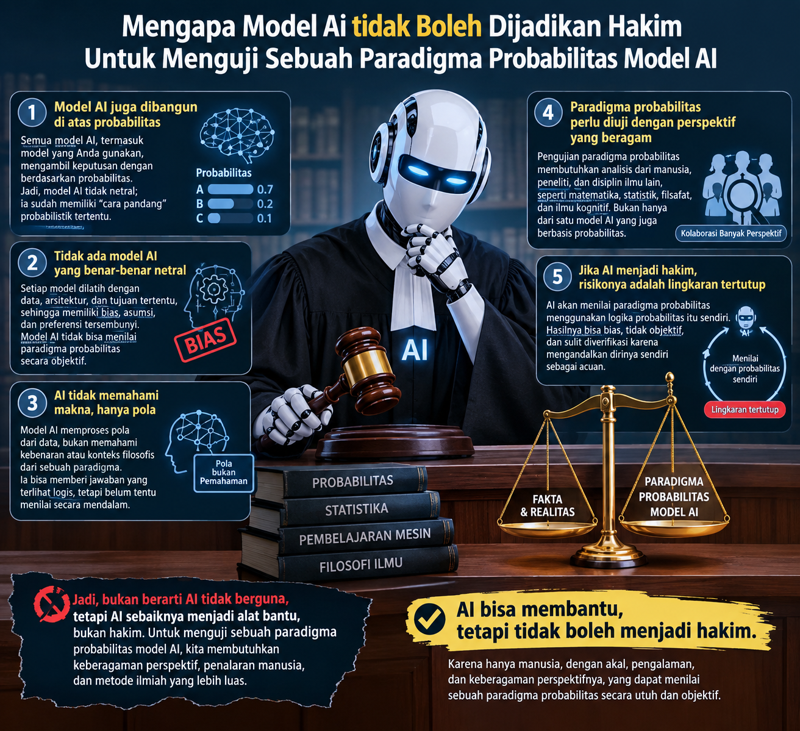
Risiko terbesar dari penggunaan AI sebagai evaluator tunggal atas paradigma fondasinya adalah munculnya bias epistemis (epistemic bias) yang berujung pada penalaran melingkar. Sebuah model AI dibangun, dilatih, dan dioptimalkan di atas paradigma probabilistik tertentu—misalnya, penggunaan fungsi Softmax konvensional dan minimalisasi metrik error lokal seperti Root Mean Square Error (RMSE). Ketika model ini diminta menilai sebuah metode alternatif yang menawarkan restrukturisasi radikal terhadap ruang tensor atau distribusi logits, model cenderung mengukur validitas metode baru tersebut menggunakan parameter lama yang sudah dikenalnya. Akibatnya, penilaian yang dihasilkan bukan lagi sebuah evaluasi independen, melainkan bentuk pembenaran diri (self-referential) dari paradigma yang menjadi fondasi model itu sendiri.
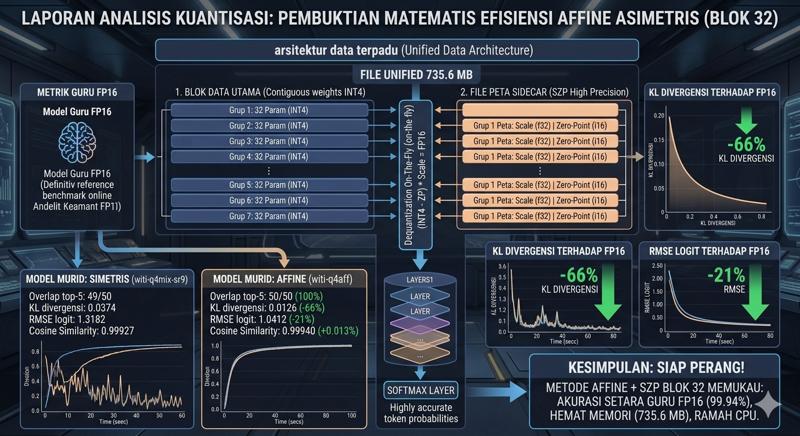
Selain itu, terdapat dikotomi yang jelas antara metrik teoretis lokal dengan perilaku runtime sistemik. Paradigma baru sering kali memunculkan anomali yang tidak nyaman bagi kerangka evaluasi konvensional. Sebagai contoh, sebuah metode kuantisasi baru mungkin menunjukkan performa yang buruk pada metrik error lokal di atas kertas, namun secara empiris mampu melenyapkan noise kompresi secara global dan memberikan stabilitas serta efisiensi memori yang jauh lebih tinggi pada tingkat operasional. Model AI yang dieksploitasi sebagai penilai tunggal cenderung terpaku pada kepatuhan kaku terhadap metrik lokal yang tertanam dalam algoritma evaluasinya, sehingga berpotensi mengeliminasi inovasi sistemik yang justru berhasil menyelesaikan masalah di dunia nyata.
Oleh karena itu, prinsip metodologi yang kuat mendikte bahwa model AI tidak boleh dijadikan satu-satunya otoritas dalam menguji pergeseran paradigma. AI tetap merupakan asisten yang luar biasa dalam memetakan data, merangkum dokumen teknis, dan mengidentifikasi pola hubungan makro. Namun, validasi akhir dari sebuah paradigma baru harus dikembalikan pada kerangka evaluasi hibrida yang melibatkan pembuktian empiris independen, uji coba mekanis pada perangkat keras riil, serta validasi manusia. Dengan membatasi peran AI sebagai alat bantu dan bukan sebagai hakim tunggal, integritas ilmiah dalam mengeksplorasi batas-batas baru teknologi kecerdasan buatan dapat tetap terjaga.