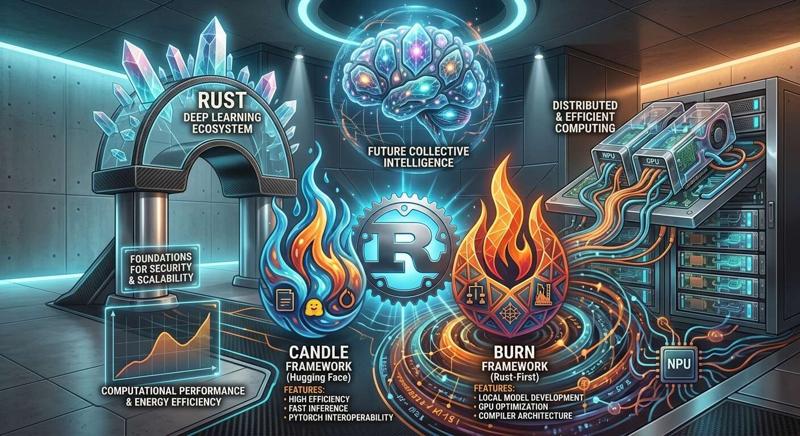
Meretas Batasan Komputasi: Bagaimana Candle dan Burn Mengubah Lanskap Deep Learning Berbasis Rust
Seiring makin kompleksnya model Artificial Intelligence (AI) dan Deep Learning, tantangan utama yang dihadapi oleh para pengembang tidak lagi hanya seputar bagaimana membuat algoritma yang pintar, melainkan bagaimana menjalankan algoritma tersebut secara cepat, aman, dan efisien. Kendati Python mendominasi ranah riset, masalah seperti pemborosan memori (memory overhead) serta tingginya latensi pada sistem produksi mendorong industri untuk mencari alternatif yang lebih tangguh.
Di sinilah Rust masuk sebagai jawaban. Melalui kombinasi performa setara C/C++ dan jaminan keamanan memori di tingkat kompilasi, Rust menjadi fondasi ideal untuk infrastruktur AI modern. Dua framework utama yang kini memimpin evolusi ini adalah Candle dan Burn.
Candle: Akselerasi Eksekusi dan Distribusi Model Tanpa Beban
Candle dipelopori oleh Hugging Face dengan satu tujuan utama: menyediakan framework yang fokus pada kecepatan eksekusi (inference) dan distribusi model tanpa kerumitan dependensi environment.
File Biner Ringkas dan Mandiri: Tidak seperti aplikasi AI tradisional berbasis Python yang memerlukan instalasi library berukuran puluhan gigabyte, Candle memungkinkan model canggih (seperti LLaMA, Whisper, atau Falcon) dikemas dan dijalankan di dalam satu file biner Rust yang sangat kecil dan cepat.
Privasi Maksimal dengan WebAssembly: Candle dapat dikompilasi langsung ke WebAssembly (WASM). Kemampuan ini memungkinkan model deep learning beroperasi secara lokal di dalam browser pengguna, menghilangkan kebutuhan untuk mengirimkan data sensitif ke server eksternal.
Dukungan Perangkat Keras Serbaguna: Candle mengoptimalkan instruksi komputasi secara langsung ke berbagai perangkat keras, mulai dari eksekusi CPU biasa, GPU NVIDIA via CUDA, hingga GPU Apple via Metal.
Burn: Fleksibilitas Arsitektur dan Ekosistem Pelatihan Lengkap
Sementara Candle berfokus pada eksekusi model secara praktis, Burn dirancang sebagai kerangka kerja deep learning yang fleksibel dan menyeluruh untuk semua tahapan—mulai dari perancangan arsitektur, pelatihan model (training), hingga tahap penyebaran (deployment).
Portabilitas Backend yang Luas: Salah satu nilai jual utama Burn adalah kemampuannya memisahkan logika model dari perangkat keras yang menjalankannya. Kode jaringan saraf yang ditulis di Burn dapat dijalankan di atas backend LibTorch (C++ PyTorch), NdArray (CPU), WGPU (GPU lintas platform), atau bahkan menggunakan Candle itu sendiri sebagai backend.
Fasilitas Training dan Autodiff Terintegrasi: Burn menyediakan fitur-fitur penting untuk melatih model dari awal, seperti kalkulasi gradien otomatis (autodiff), algoritma pembaruan bobot (optimizers), hingga pelacakan performa model.
Pencegahan Error Sejak Dini: Mengandalkan compiler Rust yang ketat, Burn dapat mendeteksi kesalahan tipe dan dimensi matriks (tensor shape mismatch) pada saat kode dikompilasi, bukan saat aplikasi sudah dijalankan.
Menentukan Pilihan: Karakteristik Candle vs Burn
Meskipun keduanya bergerak di ranah yang sama, Candle dan Burn dirancang untuk menyelesaikan permasalahan yang berbeda di dalam rantai pengembangan AI.
Candle unggul ketika fokus utama pengembang adalah mengintegrasikan model open-source yang sudah terlatih (pre-trained models) ke dalam produk jadi dengan ukuran biner sekecil mungkin. Pendekatannya yang minimalis dan ramah browser menjadikannya pilihan utama untuk pengembangan aplikasi Edge AI dan produk yang mengutamakan privasi pengguna.
Di sisi lain, Burn ditujukan bagi pengembang atau peneliti yang membutuhkan fleksibilitas penuh untuk merancang, menguji, dan melatih arsitektur model baru. Dengan sistem backend yang modular dan ekosistem training yang matang, Burn memberikan kebebasan eksperimen yang setara dengan PyTorch, namun dengan keandalan dan performa khas bahasa Rust.
Implikasi Bagi Industri AI Masa Depan
Perkembangan pesat Candle dan Burn membawa dampak langsung pada bagaimana sistem kecerdasan buatan dibangun dan dioperasikan di dunia nyata:
Efisiensi Biaya Operasional Cloud: Aplikasi AI yang dioptimalkan dengan Rust membutuhkan lebih sedikit RAM dan CPU untuk melayani jumlah pengguna yang sama, memangkas biaya sewa server secara signifikan.
Keandalan Sistem Kritis: Tidak adanya memory leak dan data race membuat kode berbasis Rust sangat aman untuk diterapkan pada teknologi berisiko tinggi, seperti sistem kemudi otonom, perangkat medis, atau sistem transaksi keuangan.
Eksekusi AI Lokal (On-Device AI): Memungkinkan pemrosesan AI secara penuh pada perangkat berdaya rendah seperti ponsel, sensor industri, atau peralatan rumah tangga pintar tanpa bergantung pada koneksi internet.
Kesimpulan
Candle dan Burn memperjelas posisi Rust sebagai masa depan infrastruktur deep learning. Candle memberikan solusi praktis untuk distribusi model yang cepat dan ringan, sementara Burn menyediakan landasan yang kokoh untuk inovasi dan pelatihan model generasi baru. Bersama-sama, kedua framework ini membuktikan bahwa ekosistem AI tidak hanya dapat berjalan lebih cepat, tetapi juga lebih aman dan efisien.
Tulisan Yang Sama
Inovasi Arsitektur AI: Mengapa Candle dan Burn Menjadi Motor Penggerak Deep Learning Berbasis Rust
28 09 2026
Mengakselerasi Komputasi AI: Bagaimana Candle dan Burn Menjadi Standar Baru Deep Learning Berbasis Rust
28 09 2026
Evolusi Deep Learning Berbasis Rust: Menelaah Peran Strategis Candle dan Burn dalam Infrastruktur AI Masa Depan
28 09 2026