Perbaikan Respon Q4 Kosa Kata Bahasa Indonesia Dengan Metode Statistik Secara Khusus yang Dikembangkan oleh Pokdartik
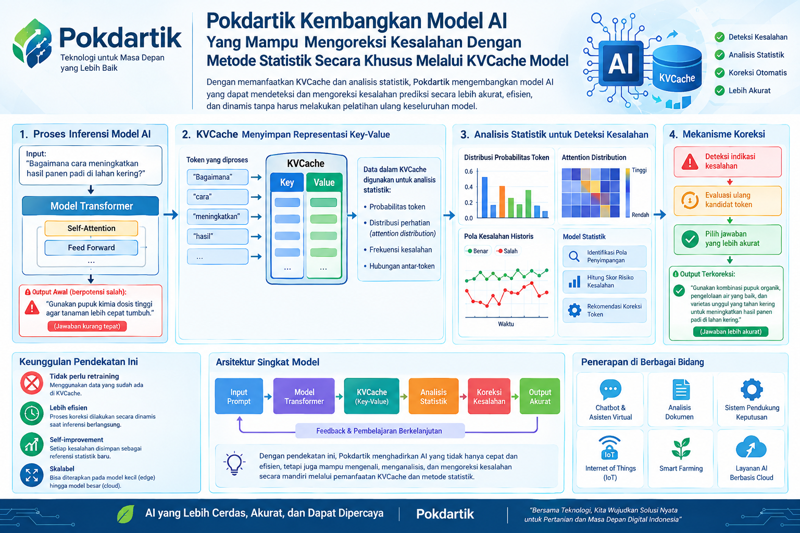
Perkembangan teknologi kecerdasan buatan (Artificial Intelligence/AI) saat ini semakin mengandalkan kemampuan model bahasa besar atau Large Language Model (LLM) dalam memahami dan menghasilkan teks yang mendekati cara berpikir manusia. Namun, salah satu tantangan utama yang masih sering ditemui adalah munculnya kesalahan pemilihan kosa kata, inkonsistensi konteks, serta keluaran token yang kurang sesuai dengan struktur bahasa Indonesia. Untuk menjawab tantangan tersebut, Pokdartik mengembangkan sebuah pendekatan perbaikan respons yang berfokus pada mekanisme statistik khusus yang diterapkan melalui pemanfaatan KVCache Model. Pendekatan ini ditujukan untuk meningkatkan kualitas respons Q4 pada pemrosesan kosa kata Bahasa Indonesia secara lebih cepat dan akurat. (Pokdartik)
Pada model bahasa modern, setiap kata yang dihasilkan sebenarnya merupakan hasil prediksi statistik dari jutaan kemungkinan token yang tersedia. Model akan menghitung probabilitas kemunculan kata berikutnya berdasarkan konteks yang telah diproses sebelumnya. Meski metode ini sangat efektif, terkadang model masih menghasilkan kata yang kurang tepat secara semantik atau tidak sesuai dengan pola bahasa Indonesia yang sebenarnya digunakan oleh pengguna. Hal ini menjadi lebih terlihat ketika model menghadapi istilah teknis, kata serapan, bahasa daerah, maupun susunan kalimat yang tidak umum. (ScienceDirect)
Pokdartik mengembangkan pendekatan yang memanfaatkan KVCache (Key-Value Cache) sebagai sumber informasi historis selama proses inferensi berlangsung. Secara umum, KVCache digunakan untuk mempercepat proses generasi teks dengan menyimpan hasil perhitungan attention sebelumnya sehingga model tidak perlu menghitung ulang seluruh konteks. Namun dalam pengembangan yang dilakukan, KVCache tidak hanya berfungsi sebagai akselerator komputasi, melainkan juga sebagai sumber data statistik yang dapat dianalisis secara real-time. (Pokdartik)
Melalui pendekatan ini, setiap token yang akan dipilih dievaluasi menggunakan mekanisme statistik tambahan. Sistem menghitung distribusi kemunculan kata, hubungan antar token, kedekatan semantik, serta pola penggunaan kosa kata Bahasa Indonesia yang telah diamati selama proses inferensi berlangsung. Dengan demikian, ketika terdapat beberapa kandidat token yang memiliki probabilitas berdekatan, sistem dapat melakukan koreksi statistik untuk memilih token yang dianggap lebih relevan terhadap konteks pembicaraan.
Salah satu fokus utama penelitian ini adalah peningkatan respons pada kategori Q4, yaitu kondisi ketika model memiliki beberapa kandidat jawaban yang hampir sama kuat secara probabilitas. Pada situasi seperti ini, model bahasa konvensional sering kali memilih token berdasarkan nilai probabilitas tertinggi semata. Akibatnya, muncul kemungkinan penggunaan kata yang kurang natural atau tidak sesuai dengan konteks kalimat secara keseluruhan. Dengan mekanisme statistik khusus yang dikembangkan Pokdartik, proses pemilihan token dapat mempertimbangkan histori pola bahasa yang tersimpan dalam KVCache sehingga hasil akhir menjadi lebih konsisten dan lebih dekat dengan penggunaan bahasa Indonesia sehari-hari. (Google Cloud Documentation)
Keunggulan lain dari metode ini adalah kecepatannya. Karena data yang digunakan berasal langsung dari KVCache yang sudah tersedia selama proses inferensi, sistem tidak memerlukan proses pelatihan ulang (retraining) yang mahal. Analisis statistik dilakukan secara ringan dan dapat diterapkan pada tahap generasi token berikutnya. Pendekatan ini memungkinkan peningkatan kualitas keluaran tanpa harus menambah ukuran model atau meningkatkan kebutuhan komputasi secara signifikan.
Dalam implementasinya, metode tersebut juga berpotensi mengurangi fenomena kebuntuan model (model stagnation) ketika model kesulitan menentukan kata berikutnya. Dengan memanfaatkan distribusi statistik yang diperoleh dari token-token sebelumnya, sistem dapat menemukan alternatif kosa kata yang mungkin tidak memiliki probabilitas tertinggi tetapi lebih tepat secara kontekstual. Hal ini membuka peluang munculnya keluaran yang lebih kaya, lebih variatif, dan lebih sesuai dengan pola bahasa Indonesia yang alami.
Konsep yang dikembangkan Pokdartik menunjukkan bahwa peningkatan kualitas model AI tidak selalu harus dilakukan melalui penambahan parameter atau pelatihan ulang berskala besar. Optimalisasi pada proses inferensi melalui pemanfaatan KVCache dan analisis statistik dapat menjadi pendekatan yang lebih efisien. Dengan memanfaatkan informasi yang sudah tersedia selama proses generasi berlangsung, model dapat melakukan koreksi internal secara cepat dan adaptif terhadap pilihan kosa kata yang dihasilkan.
Ke depan, pendekatan ini berpotensi diterapkan pada berbagai sistem AI berbahasa Indonesia, mulai dari chatbot, mesin pencari berbasis AI, asisten virtual, hingga sistem analisis dokumen. Dengan kemampuan memilih kosa kata yang lebih tepat dan kontekstual, kualitas interaksi antara manusia dan AI dapat meningkat secara signifikan. Pengembangan ini juga menunjukkan bahwa riset lokal dapat memberikan kontribusi penting dalam meningkatkan kemampuan AI untuk memahami karakteristik bahasa Indonesia secara lebih mendalam.
Referensi
Pokdartik. "Model AI yang Mampu Mengoreksi Kesalahan Melalui KVCache Model". (Pokdartik)
CASTLE: Context-Aware Semantic Transformer for Indonesian Grammar Error Correction. (ScienceDirect)
Indonesian Grammar Error Correction Dataset (GEC-GEE). (GitHub)
Google Cloud Architecture – Guidelines for Developing High Quality ML Solutions. (Google Cloud Documentation)
Improving Interactive In-Context Learning from Natural Language Feedback. (Hugging Face)
Tulisan Yang Sama
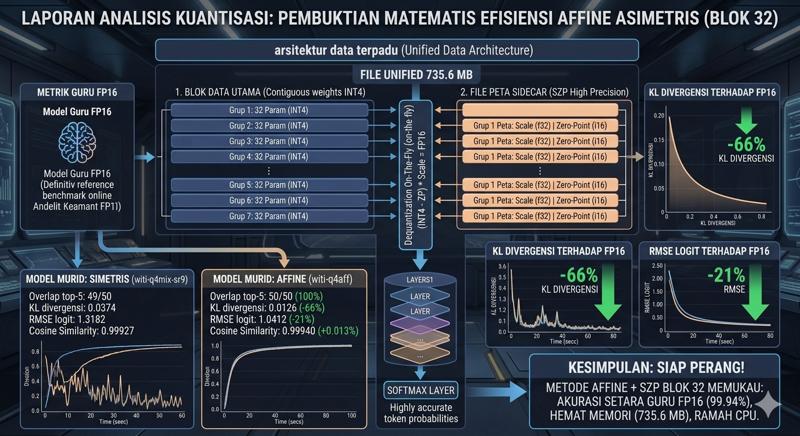
Laporan Analisis Kuantisasi: Pembuktian Matematis Efisiensi Metode Affine Asimetris Berbasis Blok 32
01 10 2026
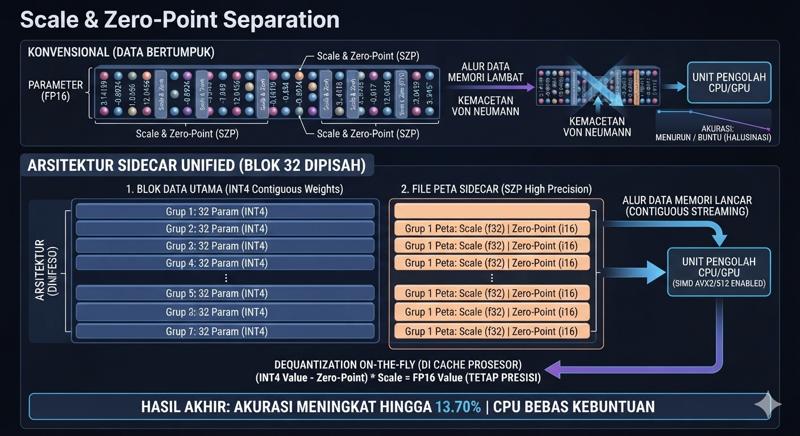
Memecah Scale Dan Zero Point Pada Proses Quantisasi Model AI LLM
01 10 2026
Pokdartik Kembangkan Model AI Yang Mampu Mengoreksi Kesalahan Dengan Metode Statistik Secara Khusus Melalui KVCache Model
19 09 2026